파일 이름 없이 그 장면을 찾습니다
그 장면은 기억납니다. 늦은 오후, 바위 위로 물이 흘러내리던 장면, 두 번째
카드 어딘가에 있었습니다. 기억나지 않는 건 그게 C0130이었는지
FF17이었는지, 어느 폴더에 넣어 뒀는지입니다.
그래서 스크럽을 합니다. 스크럽이 느린 이유는 스크럽 자체가 아닙니다 — 파일 이름이 애초에 그 장면을 설명한 적이 없고, 촬영이 진행되는 동안 푸티지에 태그를 달 시간이 있는 사람은 아무도 없기 때문입니다.
본 것을 그대로 입력하세요
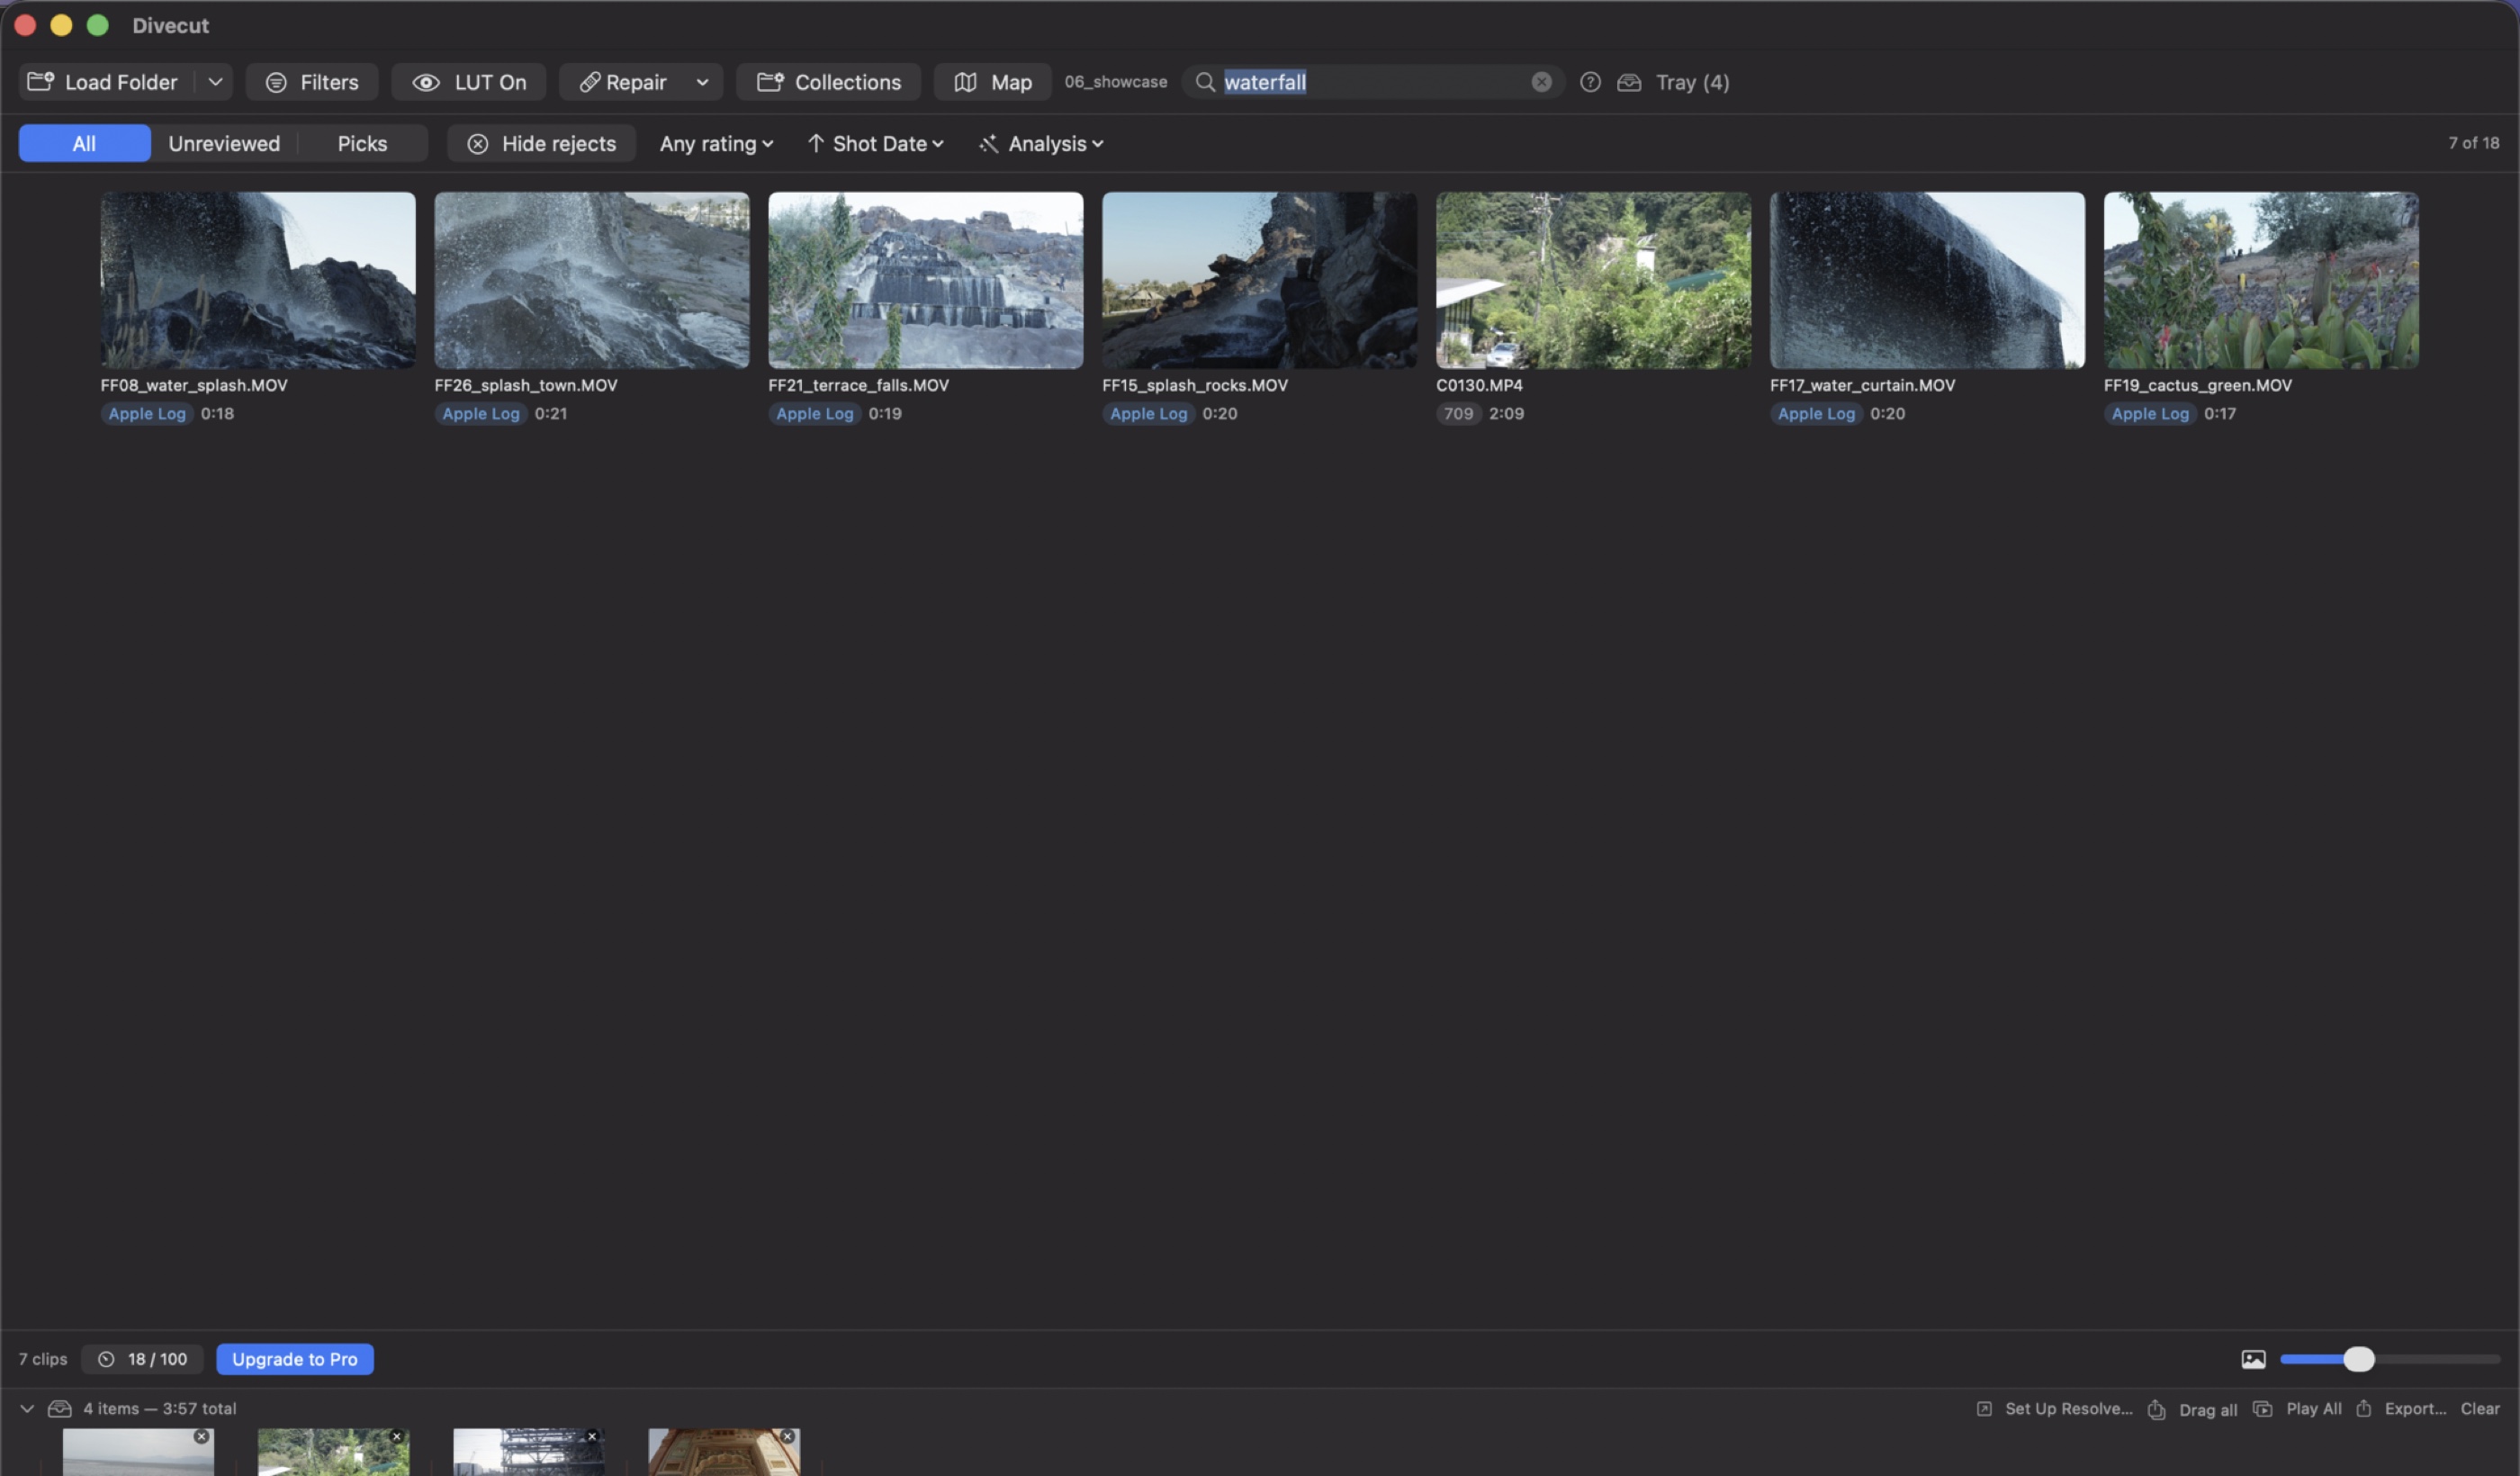
Divecut은 입력한 말을 프레임 자체와 대조합니다. 파일 이름도, 써 본 적 없는 태그도, 폴더도 아닙니다. 결과는 순위가 매겨져 있어서, 가장 가까운 장면이 애매한 후보들 목록에 파묻히지 않고 맨 앞에 나옵니다.
하나를 열면 실제로 일치하는 지점의 초로 바로 이동합니다. 찾던 것이 4분짜리 클립의 30초 지점에 딱 한 번 나올 때 이건 꽤 중요합니다.
간단히 말하면 이렇게 동작합니다
폴더를 추가하면 Divecut은 각 클립을 2초 간격으로 샘플링하고, 그리드에서 보이는 화면과 같은 방식으로 그 프레임들을 변환한 뒤, Google의 SigLIP 2 모델에 통과시켜 임베딩을 만듭니다. 검색어도 같은 방식으로 임베딩으로 바뀌어 그 값들과 비교됩니다.
알아 둘 만한 결과가 두 가지 있습니다:
- 소리가 아니라 화면을 봅니다. 모델은 오디오를 듣지 않으므로, "누군가 액션이라고 외친 장면"은 답할 수 없는 질의입니다.
- 클립당 한 번만 일어납니다. 인덱싱은 임포트 후에 실행됩니다. 그 뒤의 검색은 숫자를 비교하는 일이라 빠릅니다.
영어로 검색하세요. 모델은 다른 언어도 받아들이지만, 프롬프트 처리는 영어를 중심으로 만들어져 있고 다른 언어들이 그만큼 잘 동작하는지는 제대로 측정하지 못했습니다 — 그래서 직접 겪어보고 알게 하는 대신, 검색창이 그 사실을 미리 알려줍니다.
아무것도 Mac 밖으로 나가지 않습니다
모델은 Core ML을 통해 사용자의 기기에서 실행됩니다. 소재는 업로드되지도, 서버로 샘플링되지도, 다른 누군가의 API가 처리하지도 않습니다. 이건 나중에 덧붙인 프라이버시 명분이 아니라 — 계약상 어디에도 업로드할 수 없는 클라이언트 소재 카드에서도 이 기능이 동작하는 이유 그 자체입니다.
또한 연결이 전혀 없어도 동작한다는 뜻이기도 합니다. 촬영 현장에서도, 비행기 안에서도, 스튜디오 네트워크를 한 번도 만난 적 없는 노트북에서도요.
이건 할 수 없는 것
슬레이트를 읽거나, 특정 인물을 이름으로 알아보거나, "포커스 풀이 잘 됐던 그 테이크"를 찾아 주지는 않습니다. 생김새로 설명할 수 있는 것을 찾아 줄 뿐입니다. 그 범위 안에서는, 장면을 기억하는 것과 그 장면을 찾아내는 것 사이의 차이 그 자체입니다.
Divecut은 macOS와 iPad용 푸티지 브라우저입니다. Log 클립을 촬영할 때 의도한 색으로 보여주고, 평범한 말로 검색하게 해 주며, 고른 클립을 Log 그대로 DaVinci Resolve로 넘깁니다. 모든 기능 보기.