Encuentra la toma sin nombrar el archivo
Recuerdas la toma. Agua cayendo sobre rocas, al final del día, en algún lugar
de la segunda tarjeta. Lo que no recuerdas es si era C0130 o
FF17, ni en qué carpeta la pusiste.
Así que haces scrub. Y la razón por la que el scrub es lento no es el propio scrub — es que el nombre del archivo nunca describió la imagen, y nadie tiene tiempo de etiquetar material mientras el rodaje está en marcha.
Escribe lo que viste
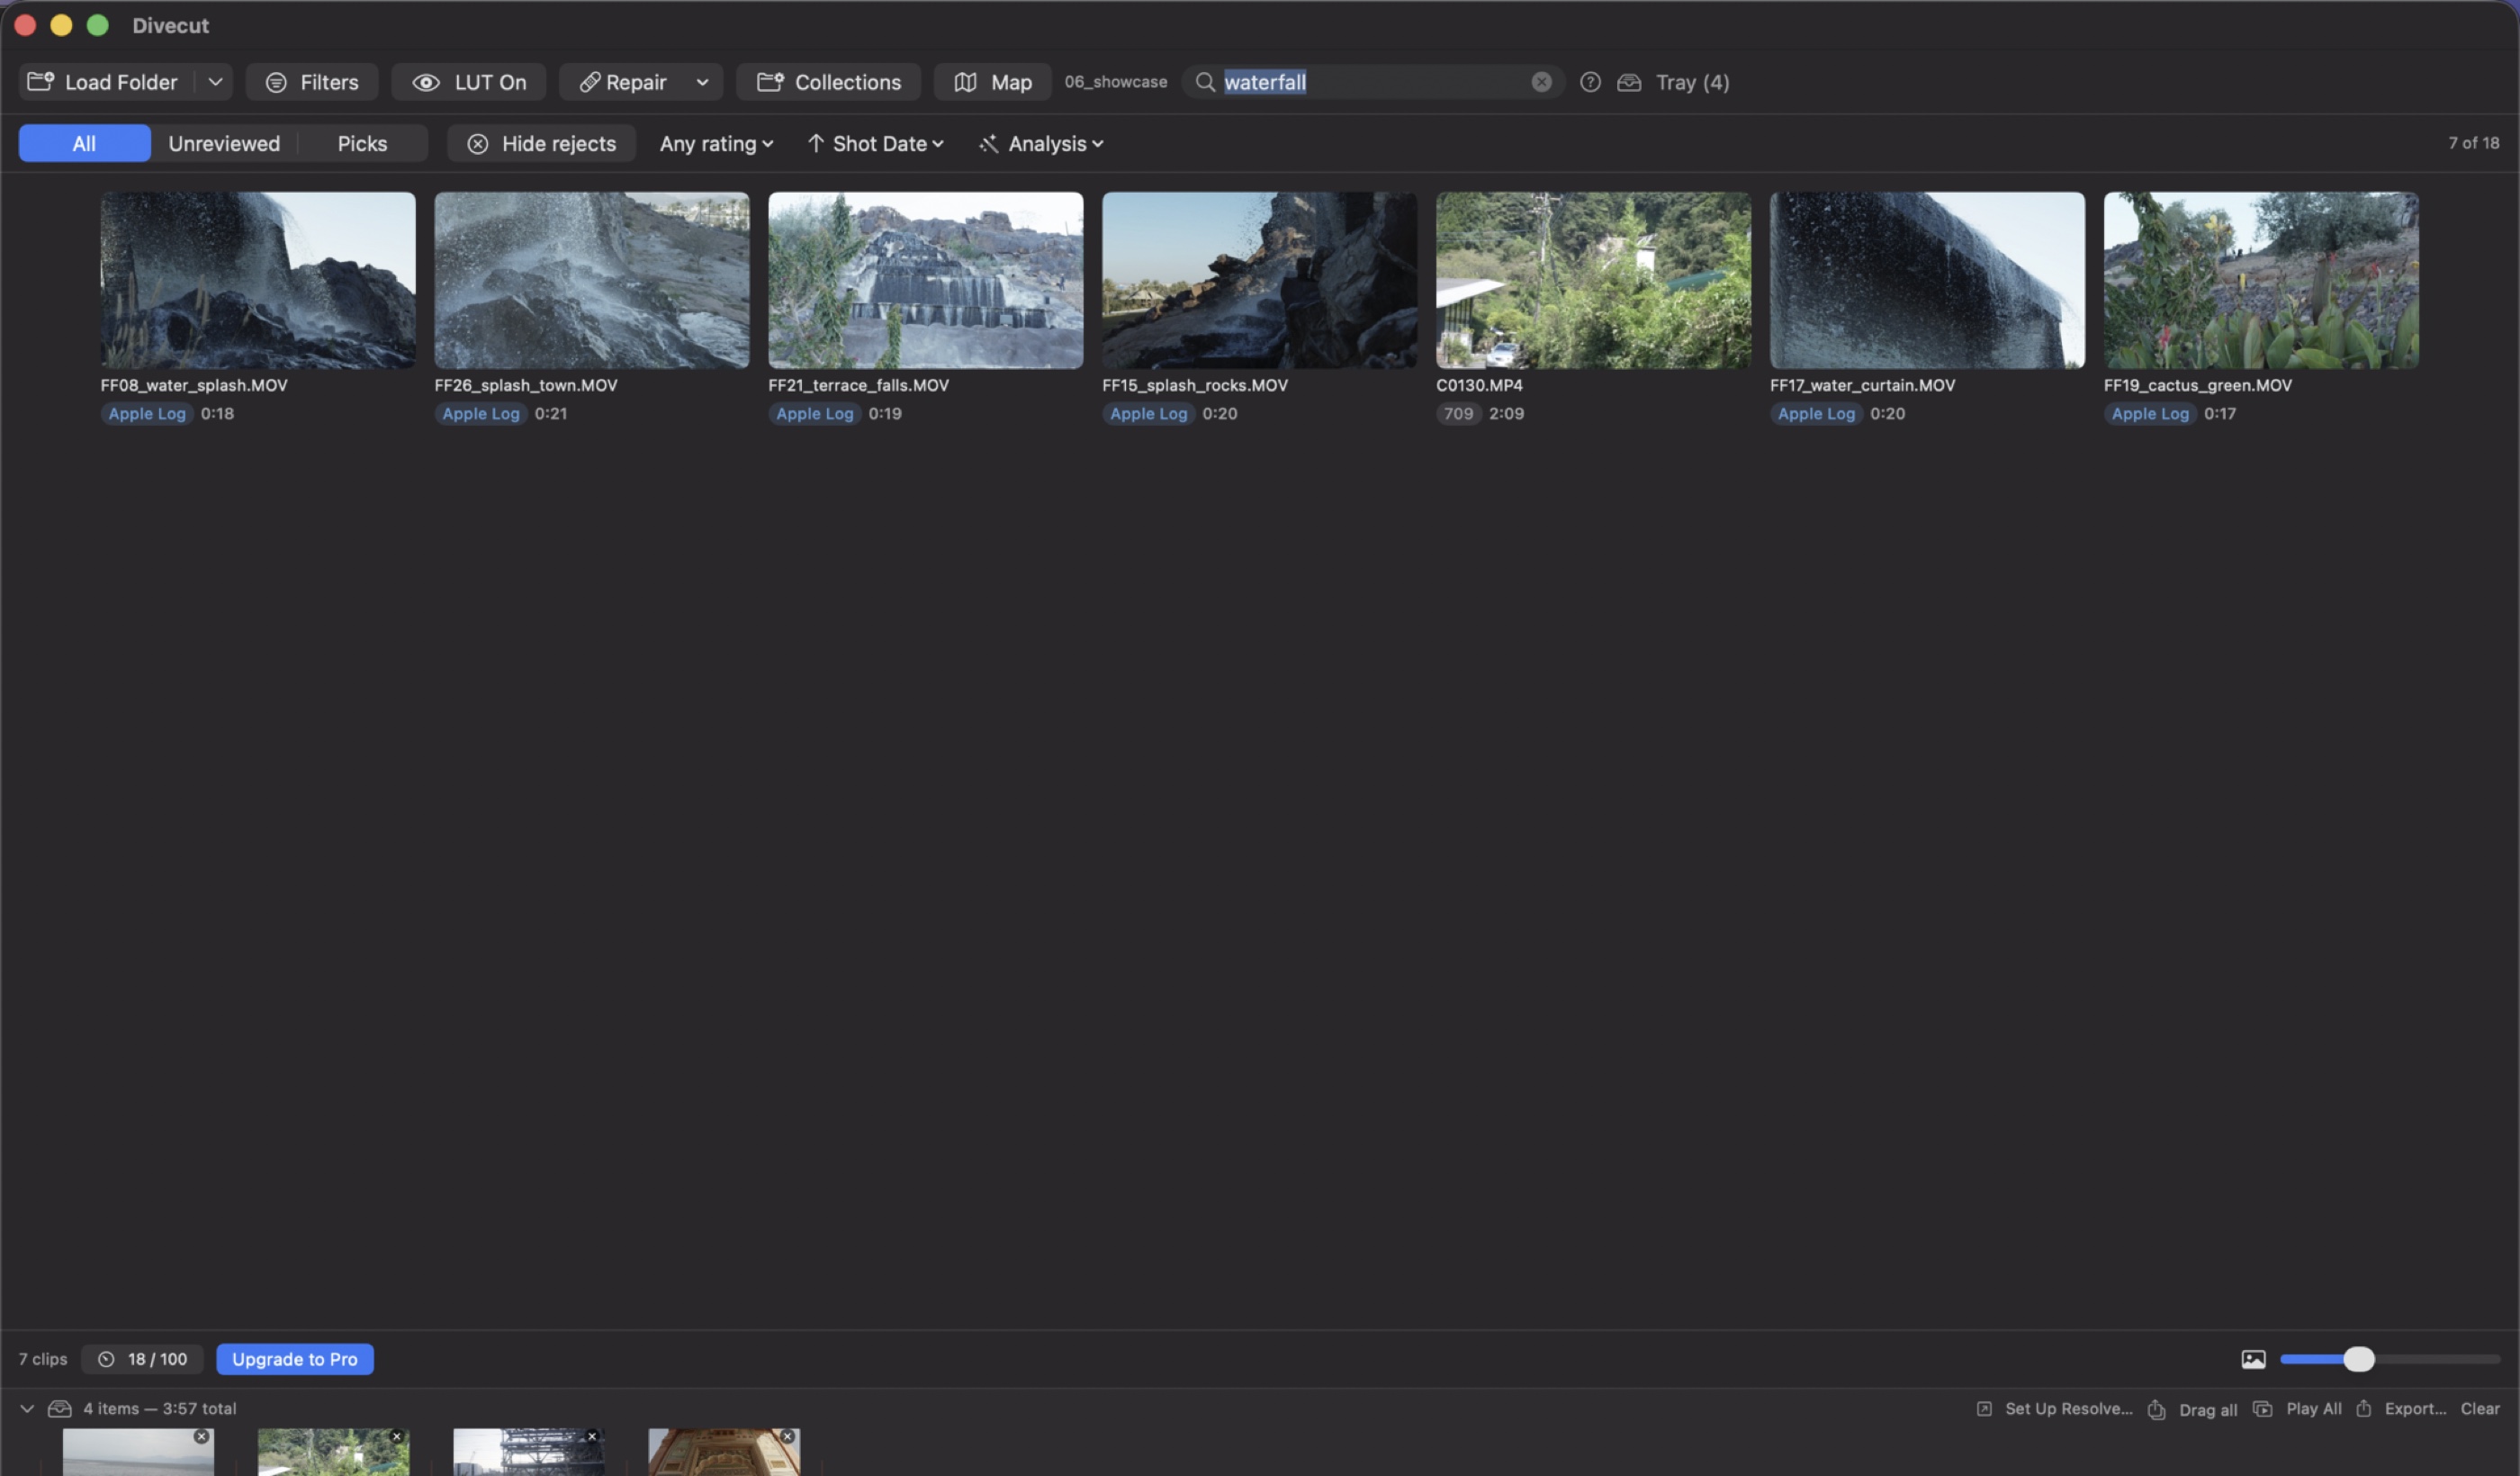
Divecut compara tus palabras contra los propios fotogramas. No el nombre del archivo, no etiquetas que nunca escribiste, no la carpeta. Los resultados se clasifican, así que la toma más cercana aparece primero en lugar de quedar enterrada en una lista de quizás.
Ábrela y salta al segundo exacto donde está la coincidencia, lo cual importa cuando lo que buscabas ocurre una sola vez, treinta segundos dentro de un clip de cuatro minutos.
Cómo funciona, en resumen
Cuando añades una carpeta, Divecut muestrea cada clip cada dos segundos, convierte esos fotogramas de la misma forma en que convierte lo que ves en la cuadrícula, y los pasa por el modelo SigLIP 2 de Google para generar un embedding. Tu consulta se convierte en el mismo tipo de embedding y se compara contra ellos.
Dos consecuencias que vale la pena conocer:
- Mira imágenes, no sonido. El modelo no escucha el audio, así que «alguien dice acción» no es una consulta que pueda responder.
- Ocurre una sola vez, por clip. La indexación se ejecuta después de importar. Buscar después es comparar números, lo cual es rápido.
Busca en inglés. El modelo acepta otros idiomas, pero el manejo del prompt está construido alrededor del inglés y no he medido los demás lo suficiente como para prometer que funcionan igual de bien — así que el campo lo indica, en vez de dejar que lo descubras por las malas.
Nada sale de tu Mac
El modelo se ejecuta en tu máquina, a través de Core ML. Tu material no se sube, no se envía como muestra a un servidor, y no lo procesa la API de nadie más. Eso no es una postura de privacidad añadida después — es la razón por la que la función funciona en una tarjeta de material de cliente que contractualmente no puedes subir a ningún sitio.
También significa que funciona sin ninguna conexión. En localización, en un avión, en un portátil que nunca ha visto la red de tu estudio.
Lo que no es
No leerá una claqueta, no reconocerá a una persona concreta por su nombre, ni encontrará «la toma en la que el foco funcionó». Encuentra cosas que puedas describir por su aspecto. Dentro de eso, es la diferencia entre recordar una toma y encontrarla.
Divecut es un navegador de material para macOS y iPad. Muestra los clips Log en el color con el que los grabaste, te deja buscarlos con palabras normales, y entrega tus seleccionados a DaVinci Resolve con el Log intacto. Ver todo lo que hace.